У цій статті розглянемо, чим відрізняється моделювання зв’язків один-до-багатьох і багато-до-багатьох у SQL та NoSQL. Також розберемо патерни, які використовують у NoSQL (документоорієнтованих базах даних), і з’ясуємо, коли який із них варто застосовувати.
Зв’язок один-до-багатьох
Уявімо, що ми розробляємо застосунок із сутностями Article і Comment. Вимоги до них такі:
- одна стаття може мати один або кілька коментарів;
- коментар може належати лише одній статті.
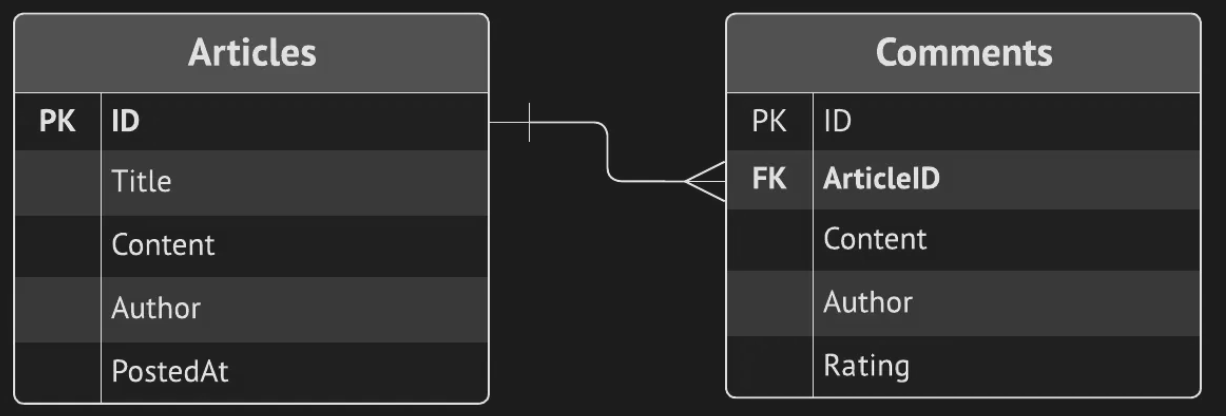
Ці вимоги означають, що між двома сутностями потрібен зв’язок один-до-багатьох (one-to-many).
У SQL-базах даних ми зазвичай створюємо дві таблиці, Articles і Comments, і додаємо зовнішній ключ у таблицю Comments, щоб встановити зв’язок один-до-багатьох. Щоб отримати статтю разом із коментарями, клієнтському коду доведеться з’єднати (JOIN) ці дві таблиці.
ArticleID у таблиці CommentsУ NoSQL-базах даних варіантів визначити зв’язок один-до-багатьох більше: посилання (referencing), вбудовування (embedding) або змішаний підхід.
Вибір між посиланням і вбудовуванням — одне з ключових рішень, які доводиться ухвалювати розробникам під час роботи з документоорієнтованими NoSQL-базами.
Патерн посилань (Referencing)
Патерн посилань у NoSQL схожий на визначення зв’язку один-до-багатьох у SQL. Ми створюємо дві окремі JSON-колекції, articles і comments, і пов’язуємо їх через ідентифікатори:
// Колекція статей (батьківська)
[
  {
    "id": 41,
    "title": "Зв’язки один-до-багатьох і багато-до-багатьох...",
    "content": "...",
    "author": "...",
    "postedAt": "..."
  }
]

// Колекція коментарів (дочірня)
[
  {
    "id": "...",
    "articleID": 41,
    "content": "...",
    "author": "...",
    "rating": "..."
  }
]
Використовуючи посилання, можна також зберігати в статті масив ідентифікаторів її коментарів. Проте це не завжди оптимальне рішення: у статті може бути дуже багато коментарів, і масив їхніх ID у документі виявиться величезним.
З патерном посилань застосунку зазвичай доводиться виконувати два запити, щоб отримати статтю та пов’язані з нею коментарі. Втім, деякі документоорієнтовані бази даних, як-от MongoDB, дають змогу з’єднати колекції в одному запиті на читання.
Коли варто використовувати посилання:
- Дочірні документи великі або їх дуже багато. Зважайте також на обмеження розміру одного документа у вашій базі даних — патерн посилань допомагає не впертися в ці ліміти.
- Батьківський і дочірні документи рідко читаються чи записуються одночасно. Якщо застосунок працює з дочірніми документами окремо від батьківського, зберігання їх у різних колекціях спростить операції читання та запису.
- Потрібно уникнути складних вкладених ієрархічних колекцій, наприклад через обмежені можливості запитів у вашій базі даних.
- На дочірні документи посилаються батьківські документи різних типів з різних колекцій. У такому разі посилання спрощують підтримку узгодженості даних.
Патерн вбудовування (Embedded)
З іншого боку, масив comments можна повністю вбудувати в документ статті:
// Колекція статей
[
  {
    "id": 41,
    "title": "Зв’язки один-до-багатьох і багато-до-багатьох...",
    "content": "...",
    "author": "...",
    "postedAt": "...",
    "comments": [
      {
        "id": "...",
        "content": "...",
        "author": "...",
        "rating": "..."
      }
    ]
  }
]
Насамперед вбудовування дає змогу отримати статтю разом із коментарями однією простою операцією читання.
Коли варто використовувати вбудовування:
- Застосунку не потрібно отримувати (чи оновлювати) дочірні документи окремо від батьківського. Згадайте концепцію агрегатів і кореня агрегату (aggregate root) у Domain-Driven Design.
- Потрібно оновлювати батьківський і дочірні документи однією атомарною операцією запису. У більшості документоорієнтованих баз даних запис атомарний лише в межах одного документа.
- Вбудовані документи невеликі, і їх небагато — зв’язок радше «один-до-кількох» (one-to-few), ніж «один-до-багатьох».
- Після створення дочірні документи оновлюються рідко або не оновлюються взагалі.
Патерн часткового вбудовування (Partial Embedded)
Третій підхід поєднує патерни посилань і вбудовування. Він стане в пригоді, коли разом із батьківським документом нам регулярно потрібна лише частина дочірніх.
Наприклад, отримуючи статтю, ми хочемо показати користувачу лише її топові коментарі. Решту можна завантажити пізніше на вимогу — або вони можуть і зовсім не знадобитися:
// Колекція статей (батьківська)
[
  {
    "id": 41,
    "title": "Зв’язки один-до-багатьох і багато-до-багатьох...",
    "content": "...",
    "author": "...",
    "postedAt": "...",
    "comments": [ // вбудовано лише 1 з 2 коментарів
      {
        "id": 1,
        "content": "...",
        "author": "...",
        "rating": 10
      }
    ]
  }
]

// Колекція коментарів (дочірня)
[
  {
    "id": 1,
    "articleID": 41,
    "content": "...",
    "author": "...",
    "rating": 10
  },
  {
    "id": 2,
    "articleID": 41,
    "content": "...",
    "author": "...",
    "rating": 3
  }
]
Патерн часткового вбудовування дає змогу отримати статтю з топовими коментарями однією операцією читання, що покращує продуктивність, і водночас зберегти частину переваг окремої колекції для всіх коментарів. Проте оскільки деякі дочірні документи зберігаються у двох місцях, застосунку доведеться виконувати додаткову роботу, щоб підтримувати їх узгодженими.
Зв’язок багато-до-багатьох
Уявімо, що в нас є сутності Project і Employee з такими вимогами:
- над одним проєктом можуть працювати кілька працівників;
- один і той самий працівник може бути одночасно призначений на кілька різних проєктів.
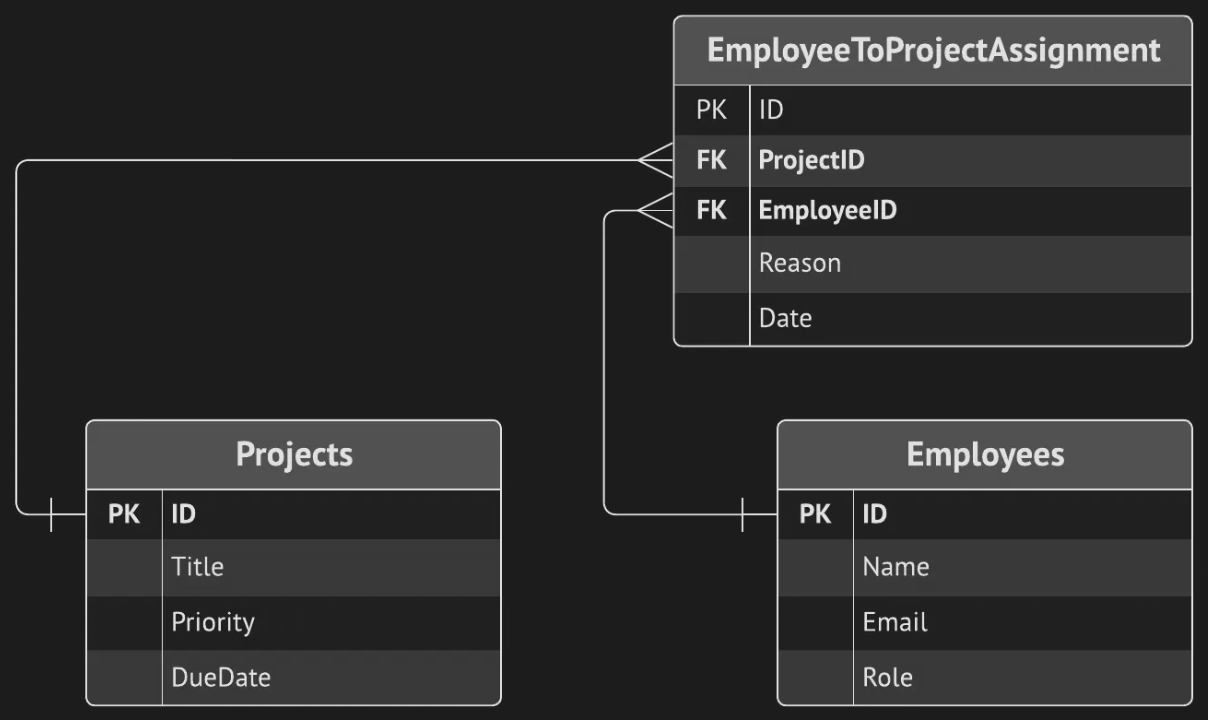
Тут нам потрібен зв’язок багато-до-багатьох (many-to-many). Він означає, що кілька записів однієї таблиці пов’язані з кількома записами іншої.
У SQL такий зв’язок визначають за допомогою додаткової таблиці:
EmployeeToProjectAssignment
Зверніть увагу, що проміжна таблиця EmployeeToProjectAssignment, окрім зовнішніх ключів, може містити й інші атрибути (Reason, Date тощо), які описують саму подію призначення.
У NoSQL є кілька способів визначити зв’язок багато-до-багатьох між двома колекціями.
Проміжна колекція (Intermediate Collection)
Перший варіант — створити проміжну колекцію, як у SQL:
// Колекція проєктів
[
  {
    "id": 41,
    "title": "E-commerce",
    "priority": "...",
    "dueDate": "..."
  }
]

// Колекція працівників
[
  {
    "id": 82,
    "name": "John Doe",
    "email": "...",
    "role": "..."
  }
]

// Проміжна колекція EmployeeToProjectAssignment
[
  {
    "id": 1,
    "projectID": 41,
    "employeeID": 82,
    "reason": "...",
    "date": "..."
  }
]
Коли можна використовувати проміжну колекцію:
- Окрім зовнішніх ключів, потрібно зберігати багато інших атрибутів, специфічних для самого зв’язку (як-от
reasonіdateу прикладі). - Зв’язок багато-до-багатьох охоплює велику кількість документів — проміжна колекція допоможе не впертися в ліміти розміру документа.
- Потрібно швидко мігрувати таблиці з SQL у NoSQL. Перенести дані з проміжної SQL-таблиці в проміжну NoSQL-колекцію, мабуть, найпростіше в реалізації.
Двонаправлені й однонаправлені зв’язки багато-до-багатьох
Інший варіант визначити зв’язок багато-до-багатьох — вбудувати список ідентифікаторів проєктів у кожен документ працівника, а список ідентифікаторів працівників — у кожен документ проєкту:
// Колекція проєктів
[
  {
    "id": 41,
    "title": "E-commerce",
    "priority": "...",
    "dueDate": "...",
    "employees": [ 1, 2 ]
  }
]

// Колекція працівників
[
  {
    "id": 1,
    "name": "John Doe",
    "email": "...",
    "role": "...",
    "projects": [ 41 ]
  },
  {
    "id": 2,
    "name": "Jane Doe",
    "email": "...",
    "role": "...",
    "projects": [ 41 ]
  }
]
Замість ідентифікаторів можна вбудовувати й документи цілком. Вибір, що саме включати, такий самий, як і для зв’язку один-до-багатьох, тож не повторюватимусь.
Але коли ви визначаєте зв’язок багато-до-багатьох через посилання чи вбудовування, є ще один цікавий момент. Важливо поставити собі запитання:
Чи справді вам потрібно моделювати зв’язок багато-до-багатьох двонаправлено?
Повернімося до попереднього прикладу. Ми можемо повністю прибрати масив employees з документів проєктів і все одно мати зв’язок багато-до-багатьох між обома колекціями. Щоправда, отримавши документ проєкту, застосунок муситиме виконати додаткову роботу, щоб знайти пов’язаних працівників: переглянути колекцію працівників і перевірити масив projects у кожному документі.
Такий спосіб моделювання підходить, коли з одного боку зв’язку дуже багато документів, а з іншого — зовсім мало. Як у нашому прикладі: над одним проєктом потенційно може працювати багато людей, але кожен працівник одночасно залучений лише до одного-двох проєктів.
Проте розмір документа — не єдиний критерій. Важливо також враховувати, як обидві колекції (сутності) використовуються у вашому застосунку.
Візьмімо інший приклад — зв’язок багато-до-багатьох між сутностями country та official_language. Якщо сценарії використання застосунку цікавить лише те, які мови є офіційними в певній країні, а не навпаки, то зберігати масив країн у документі officialLanguage просто надлишково. Достатньо зберігати масив мов у документі country.
Висновок
Ми порівняли, як визначаються два найпоширеніші типи зв’язків між сутностями в SQL і NoSQL базах даних. Як бачите, завдяки гнучкості документоорієнтованих баз NoSQL пропонує більше варіантів для зв’язків один-до-багатьох і багато-до-багатьох, ніж SQL.
Щоб обрати найвідповідніший варіант для свого випадку, враховуйте сценарії використання застосунку, патерни доступу до даних, потрібний рівень узгодженості, обмеження розміру документа та інші фактори.
Це переклад моєї англомовної статті «Many-to-Many/One Relationships are Simple in SQL, but Hard in NoSQL», опублікованої на Medium у січні 2024 року.